Kızıl Gezegenin Biyolojik Şifresi II: Masa Başında Uzay Biyolojisi - Açık Veriyle İlk Biyoinformatik Analizimiz
İlk yazıda genom, transkriptom ve metagenomik gibi temel kavramları ele almış, biyoinformatiği bir kütüphanedeki bilgiyi düzenleme ve yorumlama sürecine benzetmiştik. Bu bölümde aynı yaklaşımı gerçek bir veri kümesi üzerinde deneyeceğiz. Yeni bir biyolojik örnek toplamadan, kamuya açık bir çalışmanın sonuçlarını inceleyecek; bir genin referans dizisine ulaşacak ve Python ile bir grafik oluşturacağız.
Fiziksel örnek toplamak, çalışmanın türüne göre laboratuvar altyapısı, biyogüvenlik önlemleri ve çeşitli izinler gerektirebilir. İnsan katılımcılarla yürütülen araştırmalarda etik değerlendirme ve kişisel verilerin korunması da ayrıca ele alınır. İnsanlara ait sağlık ve genetik verilerle ilgili KVKK hükümleri, bitki örneklerinin analizine doğrudan genellenemez. Burada kullanacağımız veriler Arabidopsis bitkilerinden elde edilmiş ve araştırmacılar tarafından paylaşılmıştır.
NASA’nın Open Science Data Repository (OSDR) gibi arşivleri, uzay uçuşları ve uzay araştırmalarıyla ilişkili yer deneylerinden elde edilen verilere erişim sağlar. Veri paylaşımında kullanılan FAIR ilkeleri; bulunabilirlik, erişilebilirlik, birlikte çalışabilirlik ve yeniden kullanılabilirliği ifade eder. FAIR olmak, bütün verilerin koşulsuz biçimde herkese açık olması demek değildir. Her veri kümesinin erişim ve kullanım koşullarına bakmak gerekir.
1. "Masa Başı Biyolojisi" (Dry-Lab) Nedir?
Fiziksel örneklerle yürütülen laboratuvar çalışmalarına wet-lab, bilgisayar üzerinden yapılan analizlere ise dry-lab denir. Bu iki yaklaşım araştırmanın farklı aşamalarında birbirini tamamlayabilir. Biz bu yazıda, yayımlanmış bir deneyin işlenmiş sonuç tablosuyla çalışacağız. Ham RNA dizileme okumalarından başlayarak bütün analizi yeniden yürütmeyeceğiz.
Bu yaklaşım, biyoinformatiğe yeni başlayanlar, amatör araştırmacılar ve analog astronot adayları için birkaç açıdan yararlıdır;
Maliyet: Bu alıştırma için laboratuvar cihazı veya reaktif satın almak gerekmez. Büyük veri analizlerinde hesaplama ve depolama maliyeti yine de oluşabilir.
Erişim: Paylaşılmış verileri, arşivin kullanım koşulları içinde bulunduğumuz yerden inceleyebiliriz.
Yeniden Üretilebilirlik: Dosyayı, kodu, yazılım sürümlerini ve seçtiğimiz eşikleri kaydederek başkalarının aynı işlemleri kontrol etmesini kolaylaştırırız.
Zaman: Hazır sonuç tabloları, veri okuma ve yorumlama pratiğine hızlı bir başlangıç sağlar. Bu, bütün hesaplamalı çalışmaların laboratuvar deneylerinden daha kısa sürdüğü anlamına gelmez.
2. Analiz Senaryosu: Ay Regolitinde Bitki Stresi
İlk yazıda Ay regolitinde yetiştirilen bitkilerin stres yanıtından söz etmiştik. Şimdi o araştırmanın verilerine bakalım:
Apollo 11’den getirilen Ay regolitinde yetiştirilen Arabidopsis thaliana bitkilerinde, JSC-1A kontrolüne göre hangi genlerin ifadesi değişmiştir?
Burada iki ayrıntı önemlidir. Bitkiler Ay’da değil, Apollo görevleriyle Dünya’ya getirilen regolit örneklerinde, Dünya’daki kontrollü koşullarda yetiştirilmiştir. JSC-1A da normal bahçe veya tarım toprağı değildir; Ay regolitinin bazı özelliklerini taklit etmek amacıyla üretilmiş bir benzetim malzemesidir. [3]
Arabidopsis thaliana, genom dizisi ve gen açıklamaları iyi çalışılmış bir model bitkidir. Deneyde Apollo 11, 12 ve 17 regolitlerinde yetiştirilen bitkiler, JSC-1A’da yetiştirilen kontrollerle karşılaştırılmıştır. Biz uygulamayı Apollo 11 karşılaştırmasıyla sınırlayacağız. Bu sonuçları doğrudan Mars regolitine veya Mars’ta kurulacak bir seraya genellemek için ek deneyler gerekir.
a. Adım 1 - Veri Avcılığı: NASA OSDR Üzerinden Veriye Ulaşma
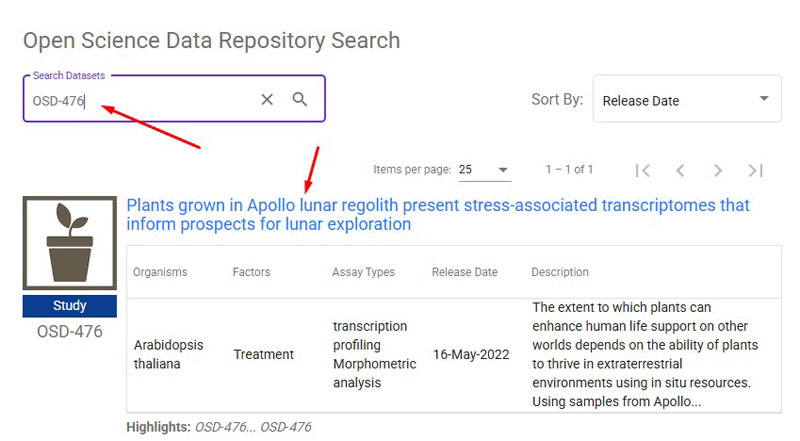
Önce NASA OSDR arşivini açın ve arama alanına OSD-476 yazın. Eski yayınlarda aynı kaydı GLDS-476 adıyla da görebilirsiniz. Çalışmanın başlığı şöyledir;
Plants grown in Apollo lunar regolith present stress-associated transcriptomes that inform prospects for lunar exploration.

Kayıtta organizmayı, deney koşullarını, yayımlanan makaleyi ve diğer arşiv bağlantılarını inceleyin. Bu çalışmanın RNA dizileme verileri NCBI Gene Expression Omnibus’ta GSE188852 erişim koduyla da bulunur. Arşiv kaydı, makale ve indirilecek dosyanın aynı deneye ait olduğunu bu bilgiler üzerinden kontrol ederiz. [3] [4]
OSDR ile GEO’yu birbirinin yerine geçen tek bir depo gibi düşünmemek gerekir. İki kayıt aynı araştırmanın farklı veri ve belgelerine erişim sağlayabilir. Dosyayı nereden aldığımızı ve hangi sürümünü kullandığımızı not etmek, analizi sonradan izlemeyi kolaylaştırır.
b. Adım 2 - Doğru sonuç tablosunu indirelim
Bu uygulamada GSE188852 kaydını açıp Supplementary file bölümündeki şu dosyayı indirin;

GSE188852_Ferl_Paul_Lunar-DiffExp-by-Apollo-Site_20211030.xlsx
Dosyanın adına dikkat edin. Aynı kayıtta bitkilerin görünüşlerine göre gruplandığı başka bir sonuç tablosu da vardır. Biz Apollo bölgelerine göre yapılan karşılaştırmayı kullanıyoruz.
Excel dosyasını açın ve Sheet1 sayfasını seçin. Bu sayfada 666 gen ve 38 sütun bulunur. Tablo, bütün test edilmiş genlerin eksiksiz listesi değildir; paylaşılmış, önceden seçilmiş bir sonuç kümesidir. Bu nedenle birazdan çizeceğimiz grafik de bütün transkriptomu temsil etmeyecek.
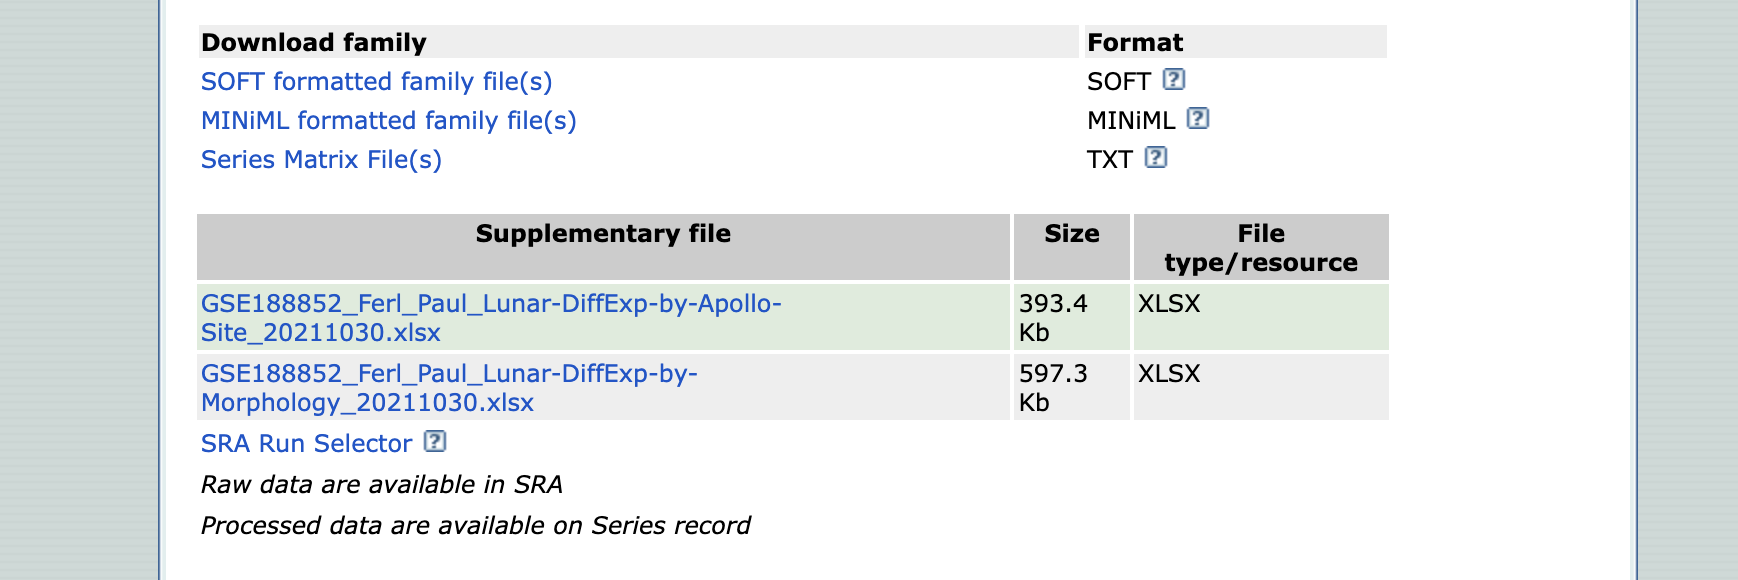
GEO’daki Series Matrix File(s) seçeneği bu alıştırma için uygun değildir. Bu kayıttan indirilen Series Matrix dosyasında örnek bilgileri ve tablo başlıkları bulunur, ancak genlere ait sonuç satırları yoktur. Aynı şekilde makalenin Supplementary Data 3 dosyasını, bütün genlerin log2 kat değişimi ve düzeltilmiş p-değerlerini içeren eksiksiz bir tablo olarak kabul edemeyiz. Makalede bu ek, seçilmiş ortak genleri göstermek için kullanılmıştır. [3] [4]
İndirdiğimiz çalışma kitabında Apollo 11 için şu sütunları kullanacağız;
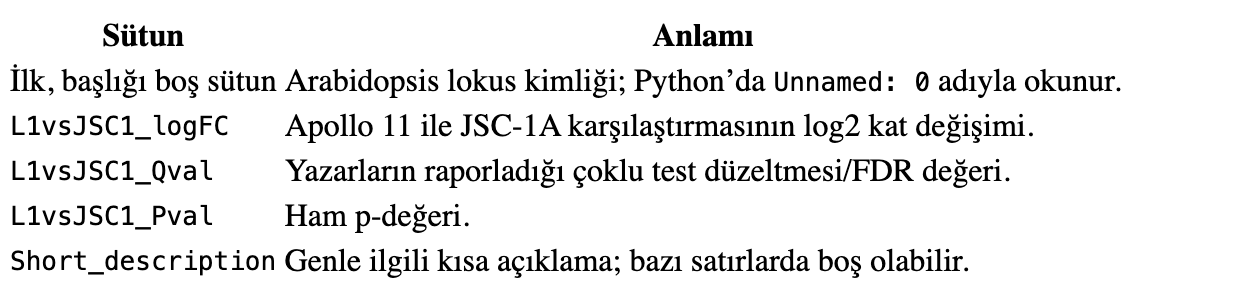
Buradaki L1, Apollo 11 karşılaştırmasıdır. Dosyada Apollo 12 ve 17’ye ait karşılaştırmalar da vardır. Sütunları karıştırmamak için seçtiğimiz karşılaştırmanın adını kodda açıkça belirteceğiz.


Dosyayı CSV’ye dönüştürmek zorunda değiliz; pandas, XLSX dosyasını doğrudan okuyabilir. CSV kullanmayı tercih ederseniz yalnızca doğru çalışma sayfasını dışa aktarın. Ondalık işareti ve sütun ayıracının yerel Excel ayarlarıyla değişebildiğini de kontrol edin.
Adım 3 - Tablodan bir gen seçelim
Excel’de L1vsJSC1_logFC sütununu büyükten küçüğe sıralayarak ifadesi artan, küçükten büyüğe sıralayarak azalan genleri inceleyebilirsiniz. Sıralama sırasında tablonun tamamını seçin. Yalnızca bir sütunu sıralarsanız gen kimlikleriyle sayısal değerler birbirinden kopabilir. En büyük kat değişimini gösteren gen, mutlaka en önemli veya en güvenilir biyolojik aday değildir. Düzeltilmiş p-değerine, başlangıçtaki ifade düzeyine ve genin açıklamasına da bakmak gerekir.
Bu yazıda dizi aramasını öğrenmek için AT5G54190 lokusunu seçelim. Bu kimlik PORA, yani klorofil biyosenteziyle ilişkili protochlorophyllide oxidoreductase A genine aittir. [5]
Seçtiğimiz tabloda PORA’nın Apollo 11 karşılaştırmasındaki log2 kat değişimi yaklaşık −3,77, Qval değeri ise 0,000111’dir. Dolayısıyla bu örnekte ifadesi azalmıştır. Bir sonraki adımda kullanacağımız referans mRNA kaydı NM_124799.4 olacaktır. Bu kaydı seçmemiz, deneyde hangi transkript izoformunun değiştiğini belirlediğimiz anlamına gelmez; tabloyu gen düzeyinde inceliyoruz. [4] [6]
Adım 4- Referans diziyi FASTA biçiminde alalım
NCBI Gene sayfasında AT5G54190 Arabidopsis thaliana araması yapın. PORA kaydını açıp RefSeq bölümünden NM_124799.4 referans mRNA kaydına geçin. Dilerseniz bu bağlantıyla doğrudan Nucleotide kaydını açabilirsiniz.


Kaydı FASTA görünümünde inceleyin. Dosya indirmek için Send to → File → FASTA → Create File seçeneklerini kullanabilirsiniz; arayüzdeki yerleşim zamanla değişebilir. Dosyanın adını indirme sırasında kontrol edin.

FASTA metninin ilk satırı > işaretiyle başlar ve dizinin kimliğini açıklar. Altındaki satırlar nükleotit dizisini içerir. Bu kayıt bir mRNA referansı olsa da NCBI’de gösterilen dizi alfabesinde T harfini görebilirsiniz. Başlık satırıyla birlikte bütün diziyi kopyalayın.

Adım 5 - Blast aramasını yapalım
NCBI Nucleotide BLAST sayfasını açın. Enter Query Sequence alanına FASTA metnini yapıştırın. Bu alıştırmada erişim kodunu, yani NM_124799.4 ifadesini doğrudan yazmak da mümkündür.
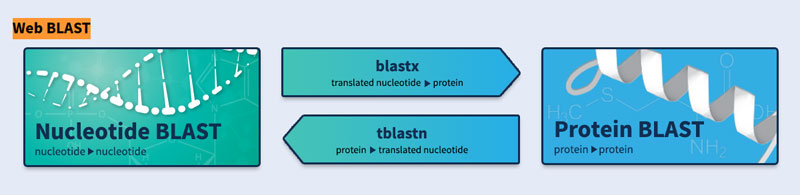
Database alanında Core nucleotide database (core_nt) seçeneğini seçin. Organism alanını boş bırakın. Program Selection bölümünde Highly similar sequences (megablast) seçeneğini işaretleyip BLAST düğmesine basın. [7]

Sonuç tablosunda öncelikle şu bilgileri birlikte inceleyin;
Description: Eşleşen kaydın açıklaması ve organizmasıdır; tek başına işlev doğrulaması değildir.
Query Cover: Sorgu dizisinin ne kadarının hizalamaya katıldığını gösterir.
E value: Bu büyüklükteki bir veritabanında aynı veya daha yüksek puanlı kaç eşleşmenin rastlantıyla beklenebileceğini ifade eder. Doğrudan “rastgele eşleşme olasılığı” değildir.
Per. Ident: Hizalanan bölgedeki özdeş nükleotitlerin yüzdesidir. Bütün sorgunun yüzde kaçının hizalandığını anlatmaz.
Accession: Sonucu doğru dizi kaydıyla ilişkilendirmemizi sağlayan erişim kodudur.
Küçük E-değeri, rastlantısal eşleşme açıklamasına karşı daha güçlü kanıt sağlar. Ekranda 0.0 görünmesi, hesaplanan değerin gösterim sınırının altında kalacak kadar küçük olduğunu belirtir; matematiksel olarak mutlak sıfır şeklinde yorumlanmamalıdır. Yüksek özdeşlik oranını da Query Cover, hizalama uzunluğu ve boşluklarla birlikte değerlendirin. [7] [8]
Veritabanından aldığımız referans dizinin kendisiyle tam eşleşmesi beklenen bir sonuçtur. Bu adım, dizi kimliğini ve BLAST çıktısını okumayı öğretir. Genin Apollo 11 regolitinde ifadesinin değişip değişmediğini BLAST’tan öğrenmeyiz; bunun için sonuç tablosuna döneriz.

6. Log2 kat değişimi ve FDR ne anlatıyor?
Gen ifadesindeki değişimi anlamak için iki ölçüyü birlikte ele alacağız. İlki log2 kat değişimi, ikincisi çoklu test düzeltmesine ilişkin değerdir. Log2 kat değişiminin temel fikri şöyle yazılabilir;
log2FC = log2(koşuldaki ifade / kontroldeki ifade)
Gerçek RNA-seq analizlerinde bu değer uygun normalizasyon ve istatistiksel model üzerinden tahmin edilir; iki ham okuma sayısını bölmekle aynı işlem değildir.
Pozitif değer artışı, negatif değer azalışı gösterir. Sıfır, tahmini oranın 1 olmasıdır. Örneğin log2FC = 3,4 ise yaklaşık 10,6 kat artış; log2FC = −3,77 ise yaklaşık 13,7 kat daha düşük bir ifade düzeyi söz konusudur. Bu sayılar tek başına istatistiksel güvenilirliği anlatmaz.
Binlerce gen ayrı ayrı test edildiğinde, gerçekte fark olmayan bazı genler şans eseri anlamlı görünebilir. Benjamini–Hochberg (BH), yanlış keşif oranını kontrol etmekte yaygın kullanılan yöntemlerden biridir. P-değerleri küçükten büyüğe sıralandığında, düzeltilmiş değerin hesabı yalnızca p × m / i işleminden ibaret değildir. Sonraki sıraların değerleriyle kümülatif minimum alınır ve sonuç 1 ile sınırlandırılır:
p_adj(i) = min(1, min_{j=i,…,m} [(m/j) × p(j)])
Burada m, düzeltmeye katılan toplam test sayısıdır. Düzeltilmiş değerler sonrasında genlerin başlangıçtaki sırasına geri yerleştirilir. FDR’yi 0,05 düzeyinde kontrol etmek, uygun varsayımlar altında seçilen sonuçlar içindeki yanlış keşiflerin beklenen oranını sınırlar; tek bir genin yüzde 95 olasılıkla doğru olduğu anlamına gelmez. [9]
Bu yazıda BH hesabını yeniden yapmayacağız. Dosyadaki Qval değerlerini, yazarların raporladığı biçimiyle kullanacağız. Makalenin açıklamasından bütün düzeltme seçeneklerini kesin olarak çıkaramadığımız için bu değerlerin hesabını ayrıca yeniden ürettiğimizi de söylemeyeceğiz. Önceden seçilmiş 666 satır üzerinden yeni bir çoklu test düzeltmesi yapmak, özgün analizin yerini tutmaz.
Grafik için Qval < 0,05 ve |log2FC| > 1 eşiklerini seçiyoruz. Bunlar bu alıştırmanın seçimleridir; her araştırmaya zorunlu olarak uygulanacak bir NASA kuralı değildir.
7. Gerçek tabloyu Google Colab’da görselleştirelim
Google Colab sayfasını açıp yeni bir not defteri oluşturun. Colab, tarayıcı üzerinden Python çalıştırmamızı sağlar. Ücretsiz kullanımda kaynak ve oturum sınırları bulunduğunu unutmayın. [10]

Dosyalar panelinden indirdiğiniz XLSX dosyasını yükleyin. Aşağıdaki kodun DOSYA satırındaki ad ile yüklenen dosyanın adı aynı olmalıdır. Dosyayı yeniden adlandırdıysanız bu satırı da güncelleyin. XLSX okurken openpyxl eksikliği bildirilirse ayrı bir hücrede %pip install openpyxl çalıştırıp kodu yeniden deneyebilirsiniz.
Aşağıdaki hücre gerçek dosyayı okur. İçinde elle yazılmış temsili gen değerleri yoktur. Çalıştırmak için hücrenin yanındaki düğmeye basın veya Shift + Enter kullanın.
import pandas as pd
from io import BytesIO
from urllib.request import urlopen

URL = (
    "https://ftp.ncbi.nlm.nih.gov/geo/series/GSE188nnn/"
    "GSE188852/suppl/"
    "GSE188852_Ferl_Paul_Lunar-DiffExp-by-Apollo-Site_20211030.xlsx"
)

print("Excel indiriliyor...", flush=True)

with urlopen(URL, timeout=30) as yanit:
    tablo = pd.read_excel(
        BytesIO(yanit.read()), sheet_name="Sheet1"
    )

print("Dosya okundu:", tablo.shape)
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.lines import Line2D
sutunlar = {
    "Unnamed: 0": "gene_id",
    "L1vsJSC1_logFC": "log2FC",
    "L1vsJSC1_Qval": "Qval",
}
eksik = set(sutunlar) - set(tablo.columns)
if eksik:
    raise ValueError(f"Beklenen sütunlar bulunamadı: {sorted(eksik)}")

df = tablo[list(sutunlar)].rename(columns=sutunlar).copy()
df["log2FC"] = pd.to_numeric(df["log2FC"], errors="raise")
df["Qval"] = pd.to_numeric(df["Qval"], errors="raise")
if df.isna().any().any() or not np.isfinite(df[["log2FC", "Qval"]]).all().all():
    raise ValueError("Tabloda eksik veya sonlu olmayan değerler var.")
if not df["Qval"].between(0, 1).all():
    raise ValueError("Qval değerleri 0 ile 1 arasında olmalı.")

# Bu alıştırma için seçilen iki eşik; Qval değerleri yeniden hesaplanmıyor.
artan = (df["Qval"] < 0.05) & (df["log2FC"] > 1)
azalan = (df["Qval"] < 0.05) & (df["log2FC"] < -1)
renkler = np.select([artan, azalan], ["#c7473d", "#356ba5"], default="#b5bac0")

# Sıfır değerleri yalnızca logaritmik eksende gösterebilmek için sınırla.
y = -np.log10(df["Qval"].clip(lower=1e-300))
fig, ax = plt.subplots(figsize=(10, 6))
ax.scatter(df["log2FC"], y, c=renkler, s=22, alpha=0.8, linewidths=0)
ax.axhline(-np.log10(0.05), color="#777777", linestyle="--", linewidth=1)
ax.axvline(1, color="#777777", linestyle="--", linewidth=1)
ax.axvline(-1, color="#777777", linestyle="--", linewidth=1)

# Metinde incelediğimiz PORA lokusunu işaretle.
for i in df.index[df["gene_id"].eq("AT5G54190")]:
    ax.annotate("PORA / AT5G54190", (df.loc[i, "log2FC"], y.loc[i]),
                xytext=(-6.8, 4.7), fontsize=9,
                arrowprops={"arrowstyle": "-", "color": "#444444", "linewidth": 0.8})

ax.set_title("Apollo 11 / JSC-1A: GEO'da paylaşılan sonuç tablosu")
ax.set_xlabel("Log2 kat değişimi (Apollo 11 / JSC-1A)")
ax.set_ylabel("−log10(Qval)")
ax.text(0.01, 0.98, f"{len(df)} gen; tüm transkriptom değildir",
        transform=ax.transAxes, va="top", fontsize=9)
lejant = [
    Line2D([], [], marker="o", linestyle="", color="#c7473d", label="Qval < 0.05; log2FC > 1"),
    Line2D([], [], marker="o", linestyle="", color="#356ba5", label="Qval < 0.05; log2FC < −1"),
    Line2D([], [], marker="o", linestyle="", color="#b5bac0", label="İki eşiği birlikte karşılamayan"),
]
ax.legend(handles=lejant, loc="upper right", frameon=False, fontsize=8)
ax.spines[["top", "right"]].set_visible(False)
ax.grid(alpha=0.15)
fig.tight_layout()
fig.savefig("Apollo11_Volcano.png", dpi=180)
plt.show()

print(f"Tabloda incelenen gen: {len(df)}")
print(f"Qval < 0.05 olan gen: {(df['Qval'] < 0.05).sum()}")
print(f"İki eşiği de karşılayan artış: {artan.sum()}")
print(f"İki eşiği de karşılayan azalış: {azalan.sum()}")
print("Bu sayılar paylaşılan tablo ve burada seçilen eşikler için geçerlidir.")

df.loc[artan | azalan].sort_values("Qval").to_csv(
    "Apollo11_Esikleri_Karsilayan_Genler.csv", index=False
)
Kod, seçtiğimiz üç sütunu okuyup sayısal değerleri kontrol eder. Yazarların Qval sonuçlarını yeniden hesaplamaz. Yatay eksende log2 kat değişimi, dikey eksende −log10(Qval) bulunur. Küçük Qval değerleri grafikte daha yukarıda görünür.
Kırmızı noktalar iki eşiği birlikte karşılayan artışları, mavi noktalar azalışları gösterir. Gri noktalar ise bu iki koşulu birlikte karşılamayan genlerdir. Gri bir noktanın Qval değeri 0,05’ten küçük olabilir; kat değişimi eşiğini geçmemiş olması da gri görünmesine yeterlidir.

8. Grafikten hangi sonuçları çıkarabiliriz?
Bu dosyanın Sheet1 sayfasında 666 gen bulunur. Kodda seçtiğimiz eşiklerle 306 artış ve 161 azalış, toplam 467 gen elde edilir. Yalnız Qval < 0,05 koşulunu sağlayan gen sayısı 472’dir. Bu sayılar, paylaşılan tablo üzerinde yaptığımız inceleme için geçerlidir.
Makale Apollo 11 karşılaştırmasında 465 farklı ifade edilen gen raporlar. Bizim basitleştirilmiş seçimimizle bu sayının aynı çıkmadığını açıkça belirtmeliyiz. Özgün çalışmada ifade düzeyine ilişkin ek koşullar da kullanılmıştır. Bu alıştırma yazarların bütün analizini baştan sona yeniden yürütmez. [3] [4]
PORA, grafiğin sol tarafında yer alır. Paylaşılan sonuç tablosunda bu genin ifadesinin azalmış olması, klorofil biyosenteziyle ilişkili bir süreç açısından araştırılabilir bir bulgudur. Ancak yalnızca bu RNA ölçümünden fotosentez hızının ne kadar düştüğünü hesaplayamayız. Protein ve fizyoloji ölçümleri gerekir.
Bir genin bu seçilmiş tabloda bulunmaması, deneyde hiç ifade edilmediği veya hiç değişmediği anlamına gelmez. Benzer biçimde, bir genin stres yanıtında görev aldığını bilmek de bu deneyde mutlaka değişmesini beklememiz için yeterli değildir.
Makaledeki genel sonuçlar, regolit ortamında yetişen bitkilerin stresle ilişkili gen ifadesi örüntüleri gösterdiğine işaret eder. Bizim tablo incelememiz ise belirli bir metal iyonunun veya cam benzeri parçacığın tek başına bu yanıtı oluşturduğunu kanıtlamaz. Bulguyu, deneyin koşulları ve diğer ölçümlerle birlikte yorumlamak gerekir.
Bu alıştırma analog araştırmalara ne kazandırır?
Bu uygulama, yeni örnek toplamadan araştırma verisiyle çalışmanın temel adımlarını gösterir. Veri kaydını bulduk, doğru sonuç tablosunu seçtik, gen kimliğiyle referans dizi arasında bağlantı kurduk ve bir görselleştirme hazırladık.
Analog astronot adayları veya yeni başlayan araştırmacılar için bu süreç; veri okuryazarlığı, gen açıklamalarını izleme, istatistiksel ölçüleri birlikte yorumlama ve bulguları açık biçimde sunma pratiği sağlar. İyi bir eğitim değerlendirmesi, yalnızca grafiğin çizilip çizilmediğine bakmaz. Katılımcının kullandığı dosyayı açıklayabilmesini ve sonuçtan hangi çıkarımların yapılamayacağını gösterebilmesini de değerlendirir.
Bu tür çalışmalar bir öğrenme yönetim sistemi içinde kullanılabilir. Ancak GitHub yerine mutlaka kurumsal GitLab veya şifreli bir LMS kullanılması gerektiği yönünde genel bir kural yoktur. Kodun ve verinin nerede tutulacağı; lisansa, veri hassasiyetine ve varsa kurumun belirlediği politikalara bağlıdır. Not defterini .ipynb olarak saklamak, dosya adını, indirme tarihini, analiz eşiklerini ve yazılım sürümlerini kaydetmek bu alıştırma için iyi bir başlangıçtır.
Bir sonraki adım
Ham dizileme verilerinden başlayacak daha kapsamlı çalışmalar için nf-core/rnaseq gibi iş akışları değerlendirilebilir. Bioconda da biyoinformatik yazılımlarının kurulumunda kullanılabilir. Bunlar her analiz için zorunlu değildir; her işletim sisteminde aynı biçimde çalışmayı da garanti etmez. Bioconda’nın desteklediği sistemler ve ilgili aracın donanım gereksinimleri ayrıca kontrol edilmelidir. [11] [12]
Gen listesinden biyolojik süreçlere geçmek için Gen Ontolojisi (GO) zenginleştirme analizi yapılabilir. DAVID ve PANTHER, gen listelerini uygun bir arka plan kümesiyle karşılaştırmak için kullanılabilecek araçlardır. REVIGO ise gen listesinden doğrudan zenginleştirme testi yapan bir araç değildir; elde edilmiş GO terimlerini özetlemek ve benzer terimlerin tekrarını azaltmak için kullanılır. [13] [15]
Buradaki 666 genlik seçilmiş listeyi, deneyde test edilmiş bütün genlerin arka planı gibi kullanmamak gerekir. Zenginleştirme analizinde hangi genlerin değerlendirmeye girebildiği, kullanılan kimlikler ve veri tabanı sürümü sonucu etkiler.
Bu yazıda açık erişimli bir uzay biyolojisi çalışmasının işlenmiş sonuçlarını inceledik. BLAST ile bir referans diziyi araştırdık; Colab’da gerçek tabloyu okuyarak volcano plot, yani yanardağ grafiği oluşturduk. Ham RNA-seq analizini yeniden yapmadık. Bu ayrımı korumak, elde ettiğimiz sonucu doğru tanımlamamızı sağlar.
Birinci yazıda ele aldığımız kavramlar böylece dosya, gen kaydı ve grafik üzerinde karşılık buldu. Sonraki yazılarda metagenomik, proteomik ve farklı çevre koşullarına ait verilerle bu uygulamayı genişletebiliriz.
Kaynakça
Bioconda. Frequently Asked Questions.
DAVID. Functional Annotation Tool — resmî yardım.
GO FAIR Foundation. FAIR ilkesi A1.2: gerektiğinde kimlik doğrulama ve yetkilendirme.
Google. Colab Frequently Asked Questions.
NASA. Open Science Data Repository.
NCBI. BLAST Command Line Applications User Manual — çıktı alanları.
NCBI. BLAST Frequently Asked Questions.
NCBI Gene. PORA / AT5G54190, Gene ID 835507.
NCBI GEO. GSE188852 — Plants grow in lunar regolith. İşlenmiş Apollo-Site XLSX tablosu, Sheet1.
NCBI Nucleotide. NM_124799.4 referans mRNA kaydı.
nf-core. rnaseq — Introduction.
PANTHER. User Manual.
Paul, A.-L., Elardo, S. M. ve Ferl, R. (2022). Plants grown in Apollo lunar regolith present stress-associated transcriptomes that inform prospects for lunar exploration. Communications Biology, 5, 382. DOI: 10.1038/s42003-022-03334-8.
R Core Team. p.adjust — Adjust P-values for Multiple Comparisons; Benjamini, Y. ve Hochberg, Y. (1995). Controlling the False Discovery Rate.
Supek, F. ve ark. (2011). REVIGO Summarizes and Visualizes Long Lists of Gene Ontology Terms.
Yazar Hakkında
Meslek: Biyoteknolog
MoEP Takımı: Astroviroloji ve Yaşamın Kökeni Arş. Takımı (AVO)
Yorumlar
Henüz yorum yapılmamış. İlk yorumu sen yap!